Le gorille invisible : ce que le cerveau voit, et ce qu'il ajoute
Michel Wozniak et Nathalie de Marcé
Publié le 14 octobre 2026 · 7 min de lecture
En bref
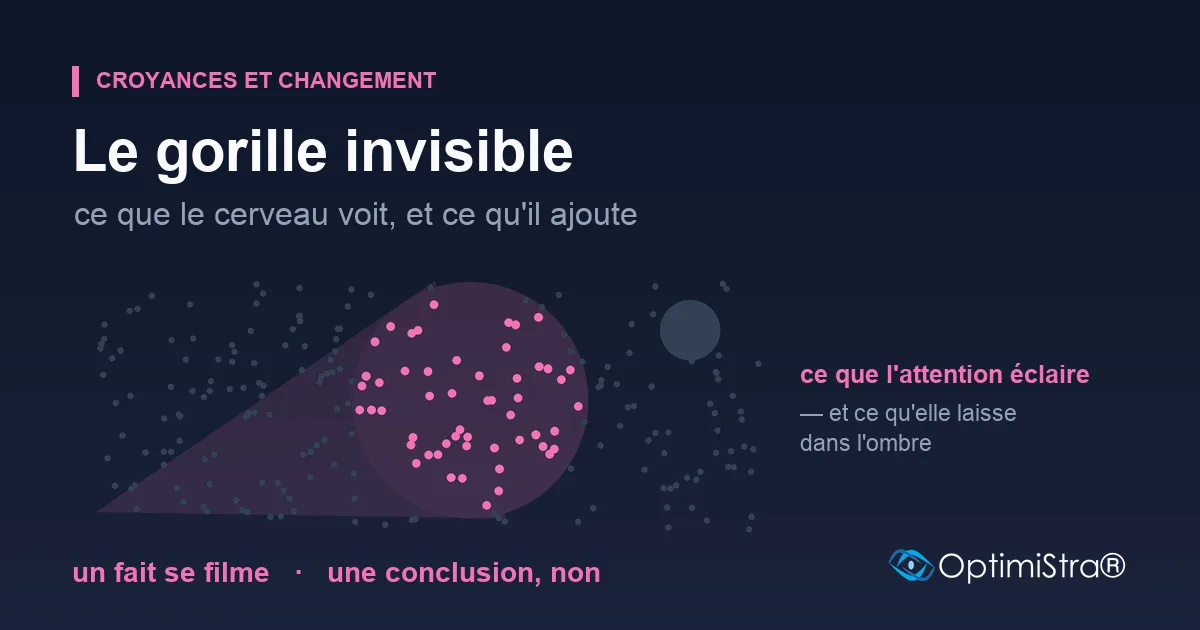
L'attention fonctionne comme une lampe-torche : elle n'éclaire qu'un endroit à la fois, et l'on peut rater un gorille en le regardant. Ce qu'elle éclaire, le cerveau le complète par des interprétations qu'il n'annonce pas. Les deux se constatent sur soi, en quelques minutes.
Avant de lire la suite, si vous ne l'avez jamais vue, regardez une vidéo d'une minute : The Monkey Business Illusion, sur la chaîne de Daniel Simons. Comptez les passes des joueurs en blanc. Ce que vous y vivrez éclaire tout ce qui suit.
Ce que vous voyez à chaque instant n'est pas une photographie du monde. C'est une construction : une petite partie de la scène, éclairée par votre attention, et complétée par ce que votre cerveau attend et sait déjà. La recherche a mesuré les deux mécanismes, ce qu'on rate et ce qu'on ajoute. Les deux se constatent sur soi, et c'est ce qui les rend intéressants.
Ce qu'on appelle la cécité d'inattention
La cécité d'inattention désigne le fait de ne pas voir un objet ou un événement pourtant bien visible, parce que l'attention est occupée ailleurs. L'image arrive bien jusqu'à l'œil ; c'est l'attention qui ne s'y pose pas.
Nous la décrivons en formation par une image : l'attention est une lampe-torche dans une pièce obscure. Elle éclaire un endroit à la fois, et ce qu'elle laisse dans l'ombre n'existe pas pour nous, même quand c'est énorme.
Le gorille invisible, en chiffres exacts
L'expérience la plus célèbre date de 1999. Daniel Simons et Christopher Chabris, dans la revue Perception, ont montré à cent quatre-vingt-douze observateurs une vidéo de soixante-quinze secondes. Deux équipes de trois joueurs, l'une en blanc, l'autre en noir, se passent un ballon. La consigne : compter les passes d'une équipe. Au milieu, pendant cinq secondes, une femme traverse la scène, avec un parapluie dans certaines versions, déguisée en gorille dans d'autres.
Le chiffre qu'on cite partout, « un sur deux », mérite d'être lu de près. Tous événements confondus, 46 % des observateurs n'ont rien vu. Mais la proportion varie énormément selon la condition : le gorille a été vu par 8 % à 83 % des gens. La tâche comptait (une tâche de comptage plus difficile faisait rater davantage), et la ressemblance aussi : le gorille, noir, était mieux vu par ceux qui suivaient l'équipe en noir. La scène fameuse, où le gorille s'arrête et se frappe la poitrine, n'a été montrée qu'à douze personnes ; la moitié l'a vue.
Les auteurs résument : « Approximately half of observers fail to notice an ongoing and highly salient but unexpected event while they are engaged in a primary monitoring task. »
Les experts ne sont pas à l'abri
On pourrait croire que l'entraînement protège. Une étude de 2013, publiée dans Psychological Science par Trafton Drew, Melissa Võ et Jeremy Wolfe, montre le contraire, d'une façon saisissante.
Vingt-quatre radiologues ont examiné des scanners pulmonaires à la recherche de nodules, de petites taches. Dans le dernier cas, les chercheurs avaient inséré un gorille « the size of a matchbook », grand comme une boîte d'allumettes, et « 48 times the size of the average nodule ». Résultat : « Twenty of 24 radiologists failed to report seeing a gorilla ». Et grâce à l'appareil qui suivait leur regard, on sait que douze des vingt qui l'ont raté avaient regardé directement l'endroit où il se trouvait.
Les auteurs mettent en garde contre la mauvaise lecture : « It would be a mistake to regard these results as an indictment of radiologists. » Le gorille ne ressemblait pas à ce qu'ils cherchaient, et c'est justement le point : une attention très bien entraînée pour une tâche ne voit pas ce qui sort de la tâche.
Connaître le piège ne protège pas du suivant
C'est ici que la vidéo du début intervient. En 2010, dans i-Perception, Daniel Simons a voulu savoir ce que fait la célébrité du gorille. Il a tourné une nouvelle vidéo, celle que nous vous proposons, où le gorille passe toujours, mais où, pendant ce temps, le rideau du fond change de couleur et un joueur quitte la scène.
Sur soixante-quatre personnes, celles qui connaissaient déjà la vidéo de 1999 ont toutes vu le gorille. Mais elles n'ont pas mieux remarqué les deux autres changements : 17 % d'entre elles, contre 29 % des autres, un écart que l'auteur juge non significatif. Sa conclusion : « Foreknowledge that unexpected events might occur does not enhance the ability to detect other such events. » Savoir qu'un piège existe ne rend pas la lampe plus large.
Croire maîtriser son attention ne prédit rien
Se croire maître de son attention ne protège pas davantage. Une étude de 2013, publiée dans PLoS ONE par David Sanbonmatsu et ses collègues, l'a mesuré.
Sur deux cent soixante-dix-sept étudiants, la capacité qu'ils s'attribuaient à faire deux choses à la fois n'avait aucun lien avec la capacité mesurée (r = 0,08, non significatif). Et ceux qui le faisaient le plus souvent, téléphone au volant compris, étaient en moyenne ceux qui y réussissaient le moins. Les auteurs écrivent que les personnes les plus enclines au multitâche sont « those with the most inflated views of their abilities », tout en soulignant que leurs résultats sont « entirely correlational ».
La conséquence pratique est simple : la lampe ne se partage pas. On ne lit pas un message en conduisant, et on n'écoute pas vraiment quelqu'un en regardant son téléphone.
Ce que le cerveau ajoute sans qu'on le lui demande
Le second mécanisme est plus discret. Ce que la lampe éclaire, le cerveau le complète, et il le fait sans qu'on le lui demande.
Lisez cette phrase : « La secrétaire a résolu l'énigme à la moitié du livre. » Vous avez probablement pensé qu'elle était maligne. Rien dans la phrase ne le dit. C'est l'exemple d'une expérience de Leonard Winter et James Uleman, en 1984, que décrivent Rim, Uleman et Trope en 2009 : « upon reading the sentence […] people spontaneously inferred the trait, "clever" ». Les chercheurs parlent d'inférence spontanée de traits, et sa caractéristique principale est d'être involontaire : ces inférences « do not require conscious awareness […] or explicit intentions ».
Une revue de Daniel Gilbert et Patrick Malone, en 1995, en tire la leçon générale : nous sommes obligés de déduire l'invisible, les intentions, les caractères, de ce qui est observable, les paroles et les gestes. « When one infers the invisible from the visible, one risks making a mistake. » Nous publions par ailleurs un article sur la façon d'observer sans interpréter trop vite, qui en tire les conséquences dans la relation.
Un exercice pour le constater sur soi
Le plus convaincant reste de le voir chez soi. Trois soirs dans la semaine :
- Choisissez une scène de la journée : une réunion, un repas, un trajet.
- Décrivez-la en faits seuls. Un fait se filme : « il a regardé sa montre deux fois » se filme ; « il s'ennuyait » ne se filme pas, c'est une conclusion.
- Relisez, et soulignez tout ce qu'une caméra n'aurait pas enregistré : une intention, une humeur, un trait de caractère.
Le nombre de soulignements n'est pas une note. Il montre le travail que le cerveau fait en silence, et qui nous sert la plupart du temps. Cesser d'interpréter est impossible ; l'enjeu est de savoir distinguer ce qu'on a vu de ce qu'on en a conclu.
Ce geste prolonge celui de la semaine précédente, sur la carte et le territoire : là, on comparait sa carte à celle d'un autre ; ici, on regarde la sienne se dessiner. Il rejoint aussi ce que nous écrivions sur les signes physiques du stress : on se souvient mal de ce qu'on a vécu, et on le reconstruit.
C'est une matière que nous enseignons dans le Leadership d'Alignement Personnel (LAP), notre formation en ligne, dans le module consacré à la réalité et à l'imaginaire.
Les ressources de cette semaine
Cet article prolonge une lettre de notre newsletter hebdomadaire, gratuite. Ce qui l'accompagne est réuni sur une seule page :
🎧 La page de la semaine — Ce que j'ai vu, ce que j'ai ajouté
- La chanson — Là où je pose la lumière, pour une journée où l'on voit ce qui est là.
- La fiche « Ce que j'ai vu, ce que j'ai ajouté » — le critère de la caméra et trois soirs à remplir.
- La vidéo d'une minute de Daniel Simons, à regarder avant tout le reste.
Michel Wozniak et Nathalie de Marcé
Article rédigé par Michel Wozniak et Nathalie de Marcé, et optimisé par l'intelligence artificielle.
Sources citées
- Simons & Chabris (1999), Gorillas in our midst: sustained inattentional blindness for dynamic events, Perception
- Simons (2010), Monkeying around with the gorillas in our midst: familiarity with an inattentional-blindness task does not improve the detection of unexpected events, i-Perception
- Drew, Võ & Wolfe (2013), The invisible gorilla strikes again: sustained inattentional blindness in expert observers, Psychological Science
- Sanbonmatsu, Strayer, Medeiros-Ward & Watson (2013), Who multi-tasks and why? Multi-tasking ability, perceived multi-tasking ability, impulsivity, and sensation seeking, PLoS ONE
- Rim, Uleman & Trope (2009), Spontaneous trait inference and construal level theory: psychological distance increases nonconscious trait thinking, Journal of Experimental Social Psychology
- Gilbert & Malone (1995), The correspondence bias, Psychological Bulletin
Questions fréquentes
Qu'est-ce que la cécité d'inattention ?
Le fait de ne pas voir un objet ou un événement pourtant bien visible, parce que l'attention est occupée ailleurs. L'image arrive jusqu'à l'œil ; c'est l'attention qui ne s'y pose pas. L'expérience du gorille invisible de Simons et Chabris (1999) en est l'exemple le plus connu.
Est-il vrai qu'une personne sur deux ne voit pas le gorille ?
En moyenne, à peu près : 46 % des 192 observateurs de l'étude de 1999 n'ont pas vu l'événement inattendu. Mais selon la tâche et les conditions, le gorille a été vu par 8 % à 83 % des gens. La scène célèbre où il se frappe la poitrine n'a été montrée qu'à douze personnes.
Les experts sont-ils moins sujets à la cécité d'inattention ?
Pas forcément. Drew, Võ et Wolfe (2013) ont inséré un gorille dans un scanner pulmonaire : vingt des vingt-quatre radiologues ne l'ont pas signalé, et douze de ceux qui l'ont raté avaient regardé l'endroit où il se trouvait. Une attention entraînée pour une tâche voit mal ce qui en sort.
Se croire bon pour faire deux choses à la fois veut-il dire qu'on l'est ?
Non. Chez 277 étudiants, Sanbonmatsu et al. (2013) n'ont trouvé aucun lien entre la capacité que chacun s'attribuait et la capacité mesurée, et ceux qui faisaient le plus souvent deux choses à la fois y réussissaient en moyenne le moins. Le résultat est corrélationnel.
Comment distinguer ce qu'on voit de ce qu'on interprète ?
Par un critère simple : un fait se filme. « Il a regardé sa montre deux fois » se filme ; « il s'ennuyait » ne se filme pas, c'est une conclusion. Décrire une scène de la journée en faits seuls, puis souligner à la relecture tout ce qu'une caméra n'aurait pas enregistré, montre en quelques minutes ce que l'esprit ajoute sans le dire.
Sur le même thème
Croyances et changement
La carte n'est pas le territoire : demander plutôt que deviner
Chacun perçoit la même réalité à travers sa propre carte, et deux cartes différentes peuvent être exactes. Le piège est de croire voir les choses telles qu'elles sont, et d'attribuer le désaccord à l'autre. Imaginer son point de vue n'améliore pas la justesse ; le lui demander, si.
14 octobre 2026 · 7 min de lecture
Croyances et changement
Créer une habitude : combien de temps faut-il vraiment ?
Répéter un apprentissage modifie les connexions entre les neurones, comme l'a montré Eric Kandel. Chez l'humain, un geste répété chaque jour met en médiane 66 jours à approcher son plus haut degré d'automatisme, avec des écarts de 18 à 254 jours. La règle des 21 jours ne tient pas, et un jour manqué ne compromet rien.
12 septembre 2026 · 10 min de lecture